エイエイレトリック

なぐりがき

# Apache EChart を next.js で表示する

Apache EChart を使って、都道府県別に酒造好適米 (日本酒向けの米) の銘柄の分布を表示するページを作ってみました。

ページ: https://shihono-nextjs-test.vercel.app/misc/sake-seisan
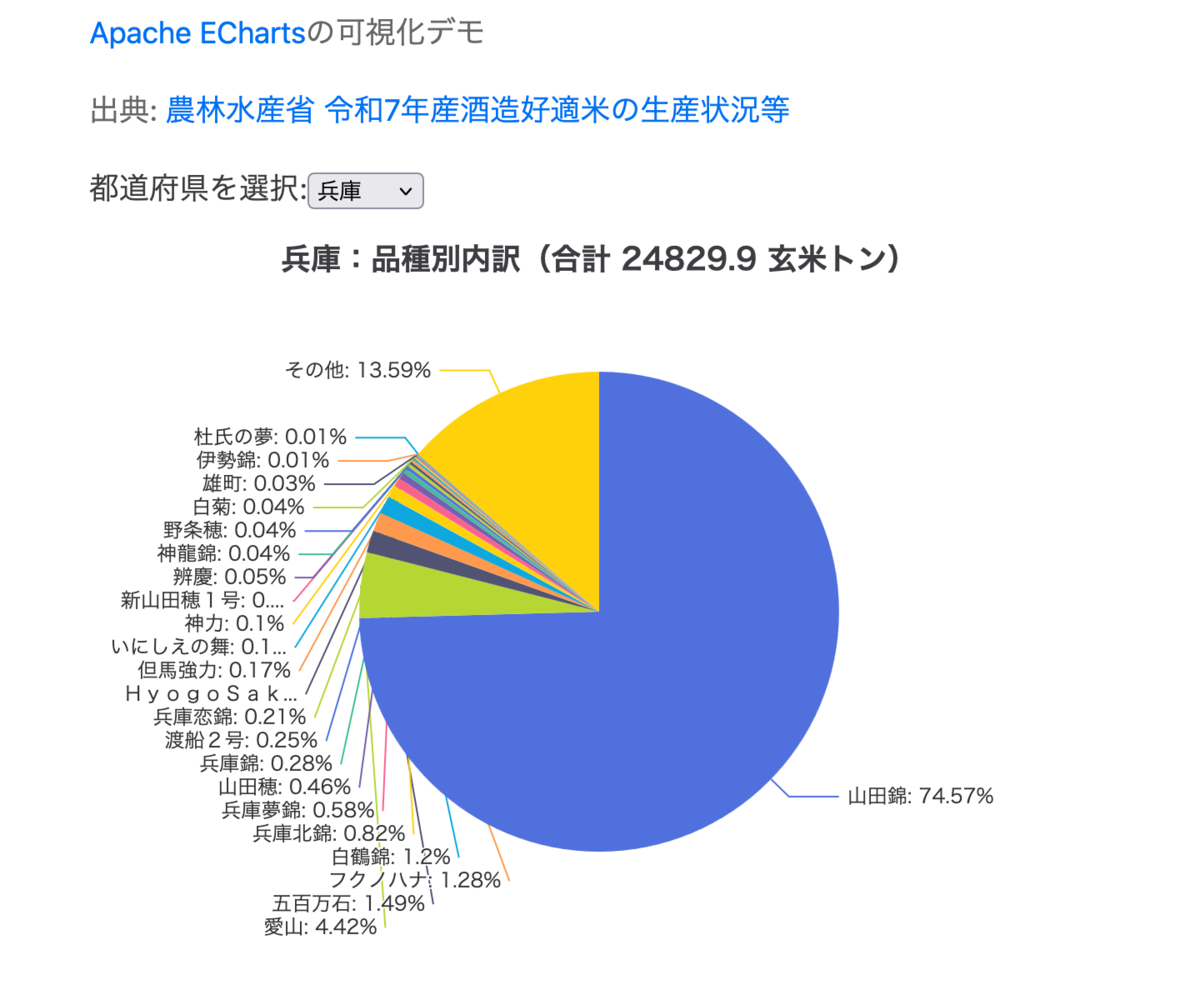
ページのスクリーンショット

Claude を使って可視化ライブラリの選定からページの実装までしました。 生成結果のコードはそのまま使わず、表示スタイルやリンク先を一部調整しています。

学んだことを記録しておきます。

// package.json でのバージョン指定
"echarts": "^6.1.0",

データの解説

(可視化の実装とは直接関係ないのですが) 今回のデータについて軽く解説します。

日本酒向けの米、酒米は正式には 酒造好適米 といい、農林水産省のページでは食用の米とは別カテゴリです。

日本酒原料米について:農林水産省

食用の米と同様、酒米も複数の銘柄があります。 日本酒原料米をめぐる状況 (PDF) によると、 「山田錦」、「五百万石」の2銘柄で全生産量の5割以上を占めてい ます。

しかし、都道府県によって生産する銘柄に違いがあります。

令和7年産酒造好適米の生産状況等 に産地・銘柄別データがあります。 今回はこちらのデータを使いました。

残念なことに pdf と 神 エクセルしかないため、 json に変換しました。

先にスキーマを決めた上で Claude を使って変換しています。

下記のように都道府県ごと生産量・内訳を持ちます。

{
"prefectures": [
    {
      "name": "兵庫",
      "total": 24829.9,
      "brands": [
        {
          "name": "山田錦",
          "value": 18516.45
        }
      ]
    }
]
}

Apache EChart

ブログに埋め込み可能かつ、都道府県ごとグラフを切り替えるような機能が欲しいという要件を満たしているので Apache EChart を選びました。

記法は matplotlib に近い気がします。 CDN を使えば静的サイトにも埋め込めます。 下記のグラフは jsDelivr 埋め込んでいます。

Claude の生成結果を一部レイアウト変更しています。データは next.js の表示しているのと同じ数値です。

<div id="sake-bar-chart" style="width:100%;height:480px;"></div>
<script src="https://cdn.jsdelivr.net/npm/echarts@6.1.0/dist/echarts.min.js"></script>
<script>
(function () {
  // https://www.maff.go.jp/j/seisaku_tokatu/kikaku/attach/xls/sake_r7seisan-7.xlsx
  var year = "R7";
  var unit = "玄米トン";
  var top10 = [
    { name: "兵庫", total: 24829.9 },
    { name: "新潟", total: 9911.91 },
    { name: "岡山", total: 6177.77 },
    { name: "長野", total: 5391.99 },
    { name: "秋田", total: 3729.5 },
    { name: "広島", total: 3370.74 },
    { name: "富山", total: 3182.18 },
    { name: "山形", total: 3067.72 },
    { name: "山口", total: 2572.93 },
    { name: "福井", total: 2448.99 }
  ];

  // chart の初期化
  var el = document.getElementById('sake-bar-chart');
  var chart = echarts.init(el);

  // 描画したい情報を指定
  chart.setOption({
    title: { text: '生産量 上位10都道府県(' + year + '年産・' + unit + ')' },
    tooltip: { trigger: 'item', formatter: '{b}: {c} ' + unit },
    xAxis: {
      type: 'category',
      data: top10.map(function (p) { return p.name; }),
      axisLabel: { fontSize: 11 }
    },
    yAxis: { type: 'value' },
    series: [
      {
        type: 'bar', // 棒グラフを指定
        data: top10.map(function (p) { return p.total; })
      }
    ]
  });

  window.addEventListener('resize', function () {
    chart.resize();
  });
})();
</script>

表示結果は以下の通り。 tooltip を指定しているため、ホバーで数値が表示されます。

nextjs のページでは都道府県を指定すると切り替えるようにしています。 これは useEffect を使ってデータを更新しているだけです。

分析

都道府県ごとの銘柄を見てみます。 比較しやすいよう、積み上げグラフにしてみました。 その県発祥の品種が強い印象。

# Translator API in Chrome を使って、オフラインで翻訳する

ブラウザ Chrome には Built-in AI (組み込みの AI) があります。

モデルをローカルにダウンロードすることで、使えるクライアントサイドの AI 機能。

オフラインでも使えるのが便利。 また、サーバーサイドにデータを送らないため、セキュリティ的な面でも安心です。

今回は Chrome 138以降で使用可能な翻訳API、 Translator API と言語検出機能である Language Detector API を使ってみました。

調べたことを記録しておきます。

ちなみに Built-in AI は現時点でPC 版 Chrome しか対応していないため、モバイルアプリでは使えません。

翻訳モデルの確認方法

Translator API に使う翻訳モデルについて。

翻訳モデルは api を使ってダウンロードできるとドキュメントには記載されています。

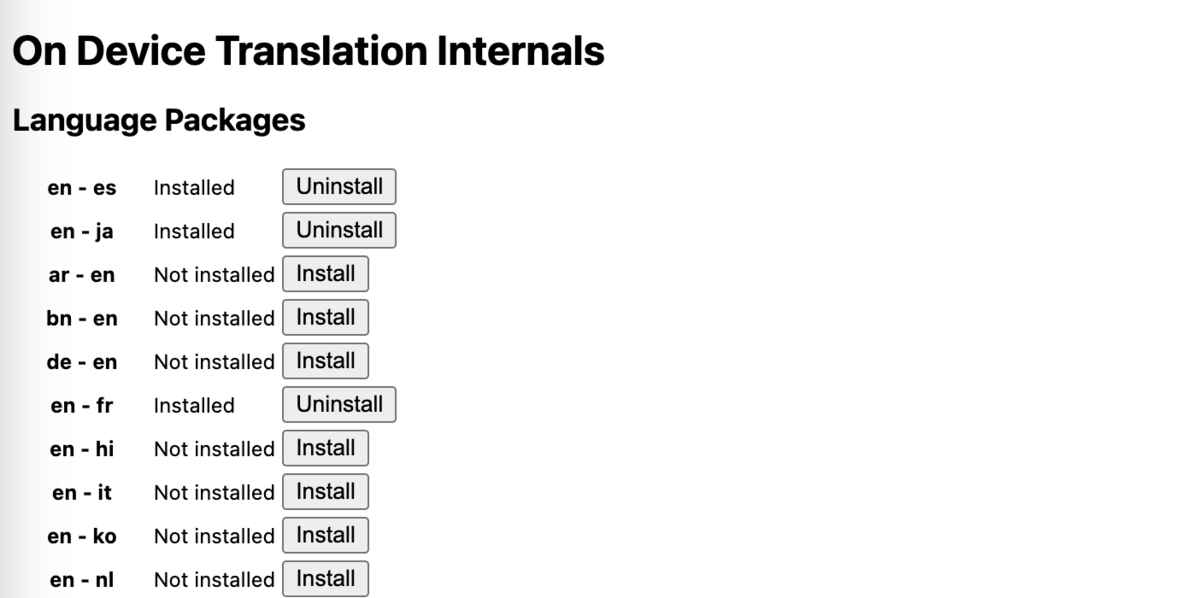
どのモデルをダウンロード済みかは chrome://on-device-translation-internals/ で閲覧できます。 アンインストールもここからできます。

on-device-translation-internals

モデルファイルは (macOS の場合) ~/Library/Application\ Support/Google/Chrome/TranslateKit/ にダウンロードされていました。

英日翻訳のファイルは以下の通り。 tflite のファイルがあるため、 TensorFlow のモデルだと思われます。

Users/XXXXXX/Library/Application Support/Google/Chrome/TranslateKit/models/en_ja/en_ja
└── 2024.9.9.1
    ├── _metadata
    │   └── verified_contents.json
    ├── en_ja_dictionary
    │   └── dictionary.bin
    ├── en_ja_nmt
    │   ├── decoder_init_0.tflite
    │   ├── decoder_step_0.tflite
    │   ├── encoder_0.tflite
    │   ├── processor_spec.pb
    │   ├── src_spm_model.model
    │   ├── src_spm_model.vocab
    │   ├── tgt_spm_model.model
    │   ├── tgt_spm_model.vocab
    │   └── translation_model.pb
    ├── ja_en_nmt
    │   ├── decoder_init_0.tflite
    │   ├── decoder_step_0.tflite
    │   ├── encoder_0.tflite
    │   ├── processor_spec.pb
    │   ├── src_spm_model.model
    │   ├── src_spm_model.vocab
    │   ├── tgt_spm_model.model
    │   ├── tgt_spm_model.vocab
    │   └── translation_model.pb
    └── manifest.json

言語検出モデルの確認方法

Language Detector API は翻訳元の言語を判定します。 判定結果は翻訳モデルの言語表記 (en, ja, es, etc...) と対応しています

翻訳モデルが対応している言語か判定する前処理のような立ち位置です。

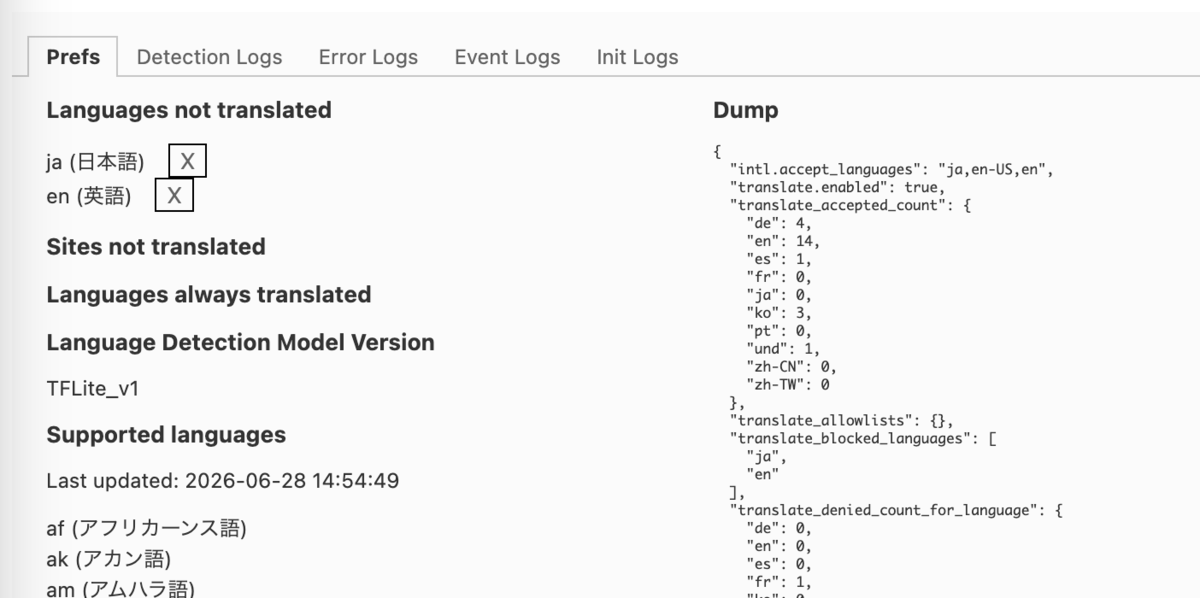
モデルのダウンロード状況、対応言語は chrome://translate-internals/ で閲覧できます。 翻訳モデルより対応範囲が広いです。

translate-internals

Language Detection Model Version TFLite_v1 と書いてあり、こちらも TensorFlow のモデルのようです。

モデルファイルはおそらく ~/Library/Application\ Support/Google/Chrome/optimization_guide_model_store/ 配下にあるのではないかと思われます。 optimization_guide_model_store/ 以下のフォルダがランダムな値になっているので特定は難しい……。

ブックマークレットで API を呼び出す

内部の仕組みを調べたところで、実際に使ってみます。

Language Detector API で言語を判定した後、日本語に翻訳した結果をマウスホバーで表示するブックマークレットです。

Claude Code で生成したコードから、過剰な装飾やCSSの微調整を外しました。 言語指定を変更すれば英日翻訳以外にも使えます。

Chrome Translator APIs で英語を日本語に翻訳するブックマークレット · GitHub

ブックマークレットの実行例(黒い部分が翻訳結果)

翻訳結果を比較

比較する文章

https://developer.chrome.com/docs/ai/language-detection で

日本語ページ (サーバーサイドでの翻訳) と比較してみます。

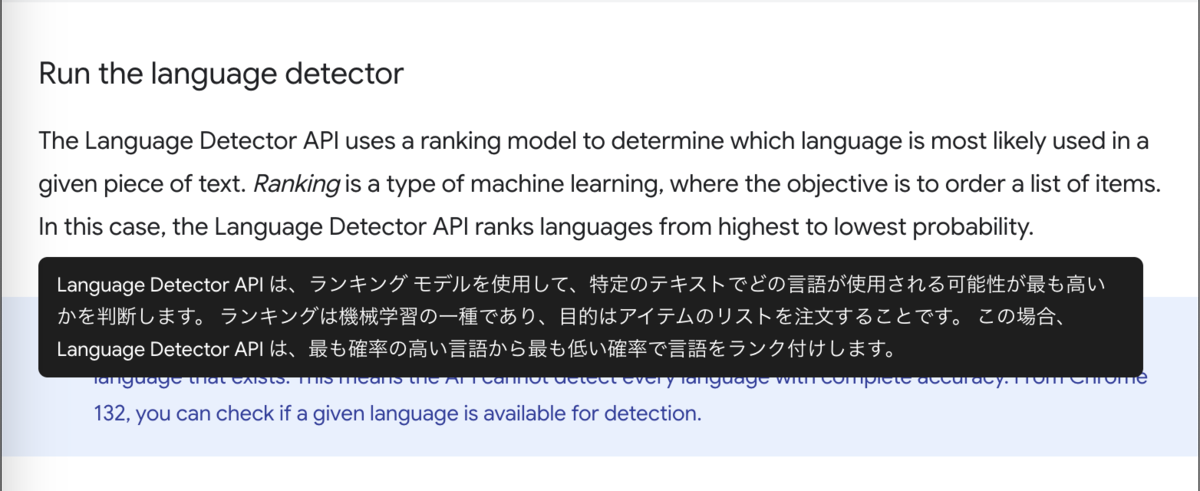
The Language Detector API uses a ranking model to determine which language is most likely used in a given piece of text. Ranking is a type of machine learning, where the objective is to order a list of items. In this case, the Language Detector API ranks languages from highest to lowest probability.

Translator API

Language Detector APIは、ランキングモデルを使用して、特定のテキストでどの言話が使用される可能性が最も高いかを判断します。 ランキングは機械学習の一種であり、目的はアイテムのリストを注文することです。 この場合、Language Detector APIは、最も確率の高い言話から最も低い確率で言話をランク付けします

日本語ページ (https://developer.chrome.com/docs/ai/language-detection?hl=ja)

Language Detector API はランキング モデルを使用して、特定のテキストで使用されている可能性が最も高い言語を特定します。 ランキング は機械学習の一種で、アイテムのリストを並べ替えることを目的としています。 この場合、Language Detector API は言語を確率の高い順に並べ替えます。

だいたい同じですが、以下が気になりました。

  • Translator API は2行目の to order a list of items を アイテムのリストを注文すること と誤訳
  • 3行目で日本語ページが 確率の高い順に並べ替えます と一部省略している一方、Translator APIは 最も確率の高い言話から最も低い確率で言話をランク付けします とほぼ直訳している

他の翻訳結果も見た限り、Translator API の方が少々流暢性に欠けるかなと思いました。

翻訳結果をそのまま使うのは微妙ですが、 (ある程度英語が読める人が) 原文を見ながら確認する用途として使う分には問題ないと思います。

日本語は英語の翻訳のみ対応なので、今後対応言語が増えることを期待します。

他の API

現時点で公開されているAPIは APIのステータス で見ることができます。

今回紹介した言語検出 API と 翻訳 API 以外は Gemini Nano ベースな模様。

developer.chrome.com

# Next.js で文字の Unicode 詳細をチェックするページを作った (Claude で)

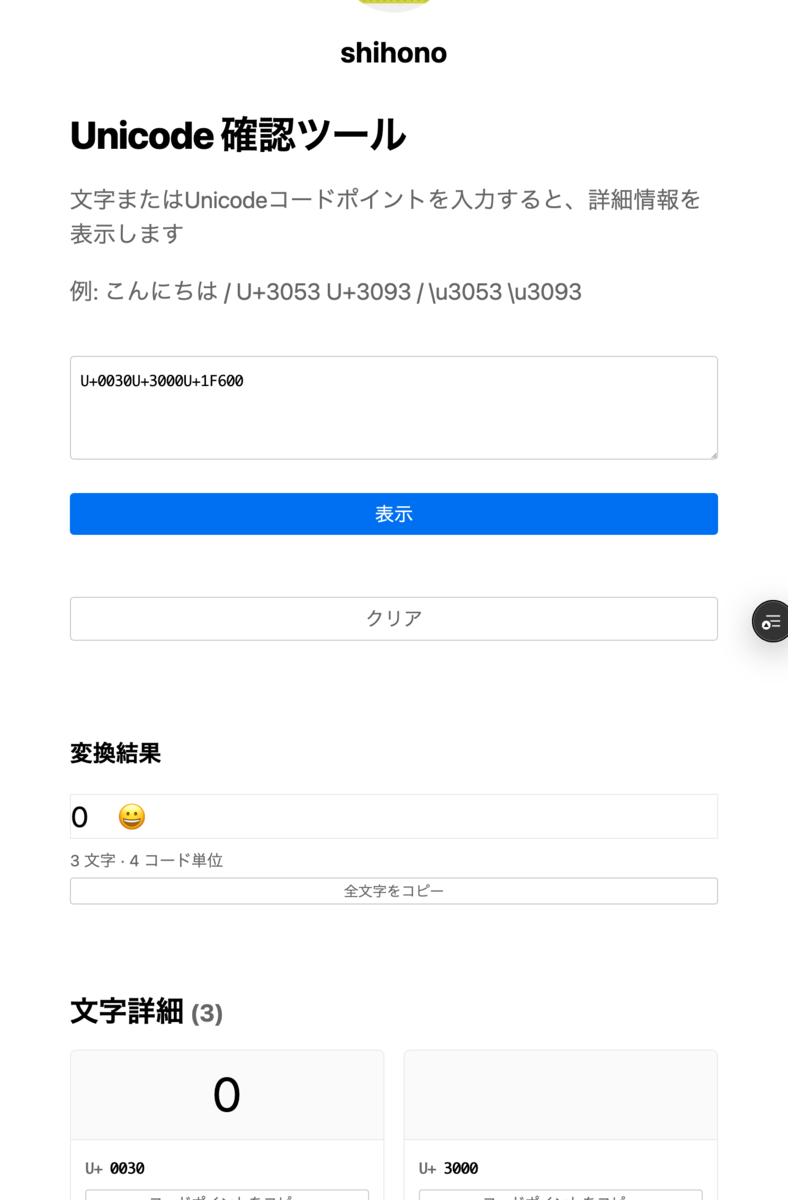
Unicode 詳細をチェックするページを作りました。

Vercel にデプロイしている Next.js アプリの misc ページに追加しました。

URL: https://shihono-nextjs-test.vercel.app/misc/unicode

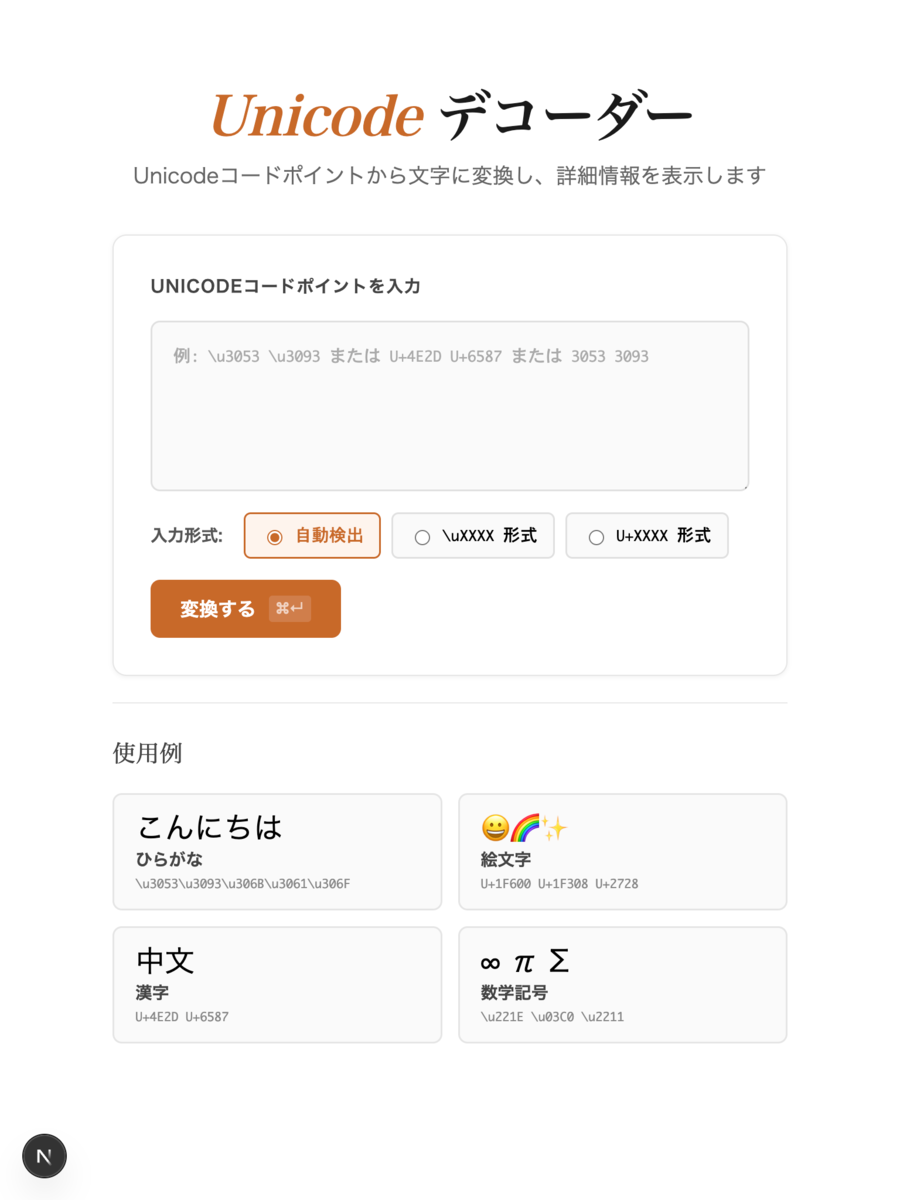
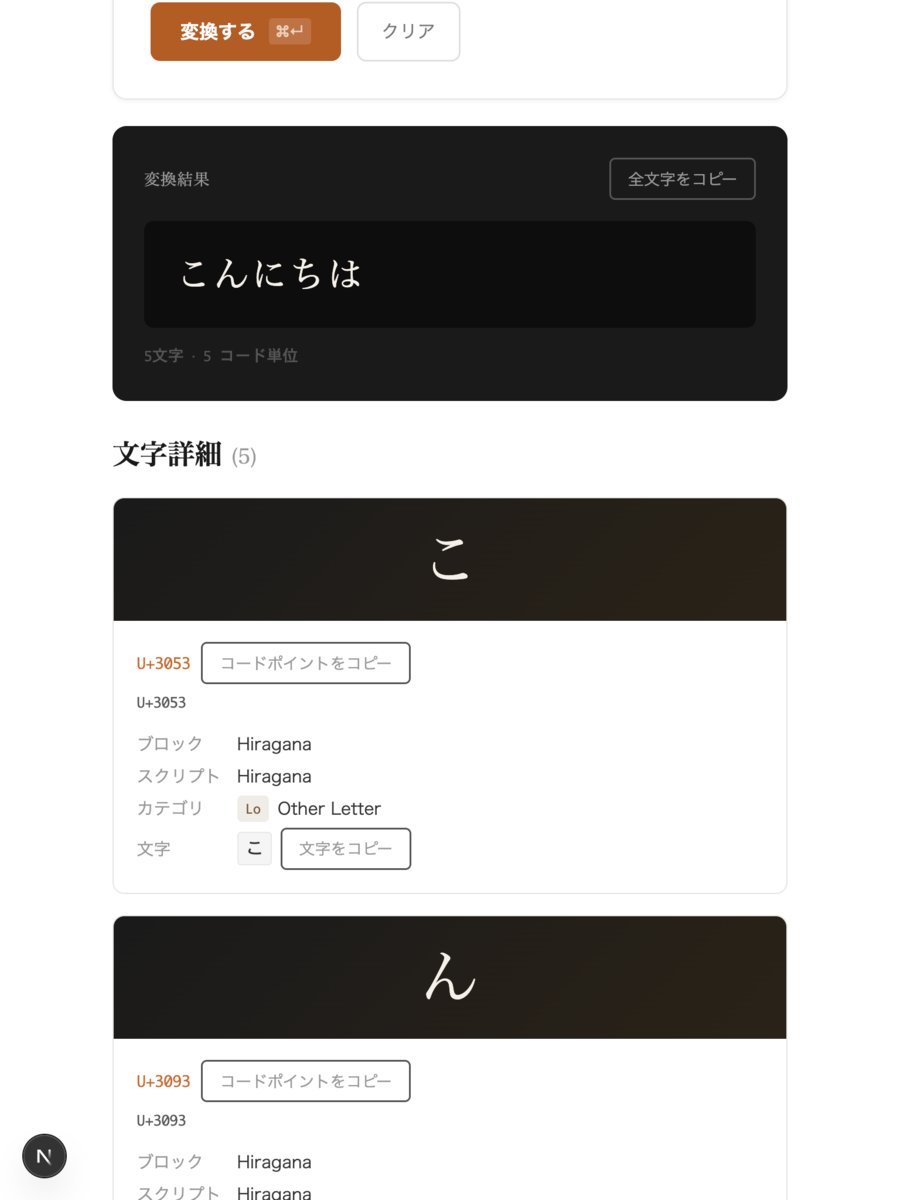
フォームに文字か unicode (\uXXXX もしくは U+XXXX) を入力すると、文字の詳細を1文字ずつ表示します。 不可視文字 *1 とか異体字とか、見た目で判断しずらい文字を調査する時に、 複数文字をまとめて表示したくて作りました。

Python の encode, decode で対応できるものの、ターミナルで実行するのが地味に面倒で。 Unicode文字一覧表 のような文字コード一覧ページもすでにあるのですが、だいたい広告が入っていて操作しずらいので、手元でも使えるものを作ろうと思った次第です。

# Next.js で TinySegmenter と kuromoji.js を実行する の時に作った仕組みと似たような方式にしています。

以降は今月やったこと記録です。

Claude で頑張った記録

この機能追加はClaude (https://claude.ai) を活用して (なるべく) コードを書かずに実装しようと試行錯誤したので、記録します。

具体的には、無料版のチャット機能で生成したらすごい複雑な機能とレイアウトが出来上がったので、 有料版の Claude Code 機能で無駄な機能を落としたり、リファクタリングしたりしました。

1回目: Claude のチャット機能で無から機能を生成する

ざっくり作りたいものを決めて、適当なプロンプト (下記) を作り、Claude に渡しました。

next.js のテンプレート https://github.com/vercel/next-learn/tree/main/basics/basics-final に機能を追加する。 pages フォルダにunicodeのコピペ機能を追加する。
技術仕様: typescript, next.js
仕様
入力

    ユニコードの値:複数文字入力可能なフォーム

    ユニコードの入力形式(オプション): 値の形式は \\u0000、 U+0000 、複数の形式に対応、オプションとして指定する
    出力表示
    ユニコードをエンコードした文字
    コピペボタン(ボタンをクリックでコピー)
    不正な値の場合はエラーを出力
    文字詳細
        エンコードした文字ごとの詳細情報を表示
        ブロック名、名称
  • FAQ
    • なぜ Claude Code でやらず、無料版でやろうとした?
    • → 単純にケチだからです。
    • なぜ実際のコードではなく、元のテンプレートの Github リンクを渡した?
    • → コードはプライベートレポジトリに置いているのに加え、コードをアップロードするのが面倒だったからです。単一ページの機能追加だから、テンプレートさえ渡せばいけると思った(AIへの過信)

これを踏まえて追加されたファイル一覧、並びに実際のページです。

## 追加ファイル一覧

| ファイル | 役割 |
|---|---|
| `pages/unicode.tsx` | Unicodeデコーダーページ(メイン) |
| `lib/unicode.ts` | パース・変換ロジック |
| `lib/unicodeBlocks.ts` | Unicodeブロック名テーブル・カテゴリ名 |
| `styles/unicode.module.css` | ページ専用スタイル |

生成結果 (1回目)

既存のレイアウト、どこへやった?

styles/unicode.module.css で既存の styles/ 配下にある CSS 設定を全て上書きしていました。

しかも、下記のように要素ごと細かい指定が多い。 あきらかに趣味でやるレベルの微調整なので、シンプルな構成にしたい自分としては困ります。 絶対管理できない。

.convertBtn {
  display: flex;
  align-items: center;
  gap: 0.6rem;
  background: #c8692a;
  color: #fff;
  border: none;
  border-radius: 8px;
  padding: 0.7rem 1.4rem;
  font-size: 0.9rem;
  font-weight: 600;
  font-family: 'DM Sans', sans-serif;
  cursor: pointer;
  transition: background 0.15s, transform 0.1s;
}

また特に利用目的を記述していなかったからか、見当違いな使用例が画面下部にデカデカと追加されました。 使用例をクリックすると textarea に挿入される機能です。プロンプトには全く記載していない。

実行結果の表示も1文字ごと横幅いっぱいに使っており、目的が謎です。

謎表示レイアウト

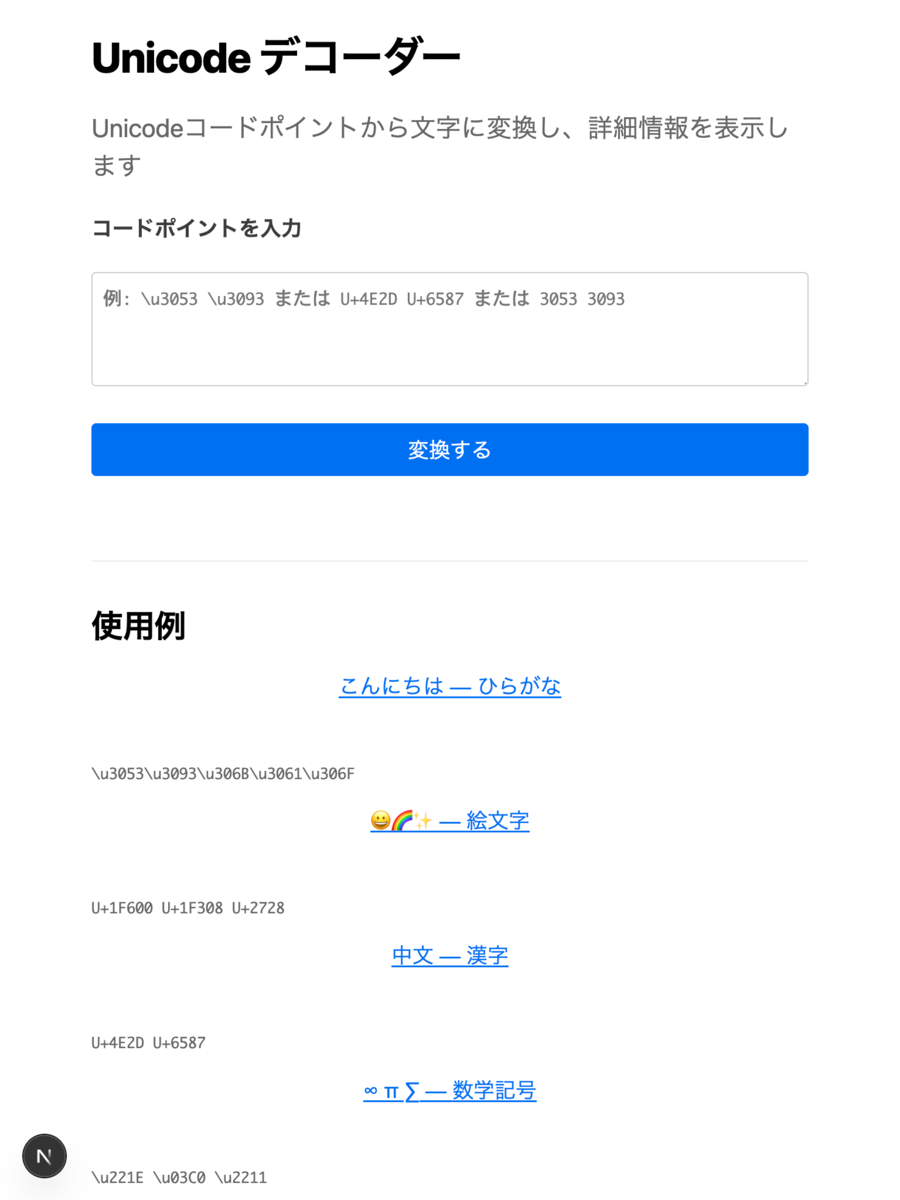
兎にも角にも CSS を必要以上に設定しているのが気に食わなかったので、styles/ 配下にある CSSで代替できるものを削除させました。

また、「自動判定できるなら入力形式を選ぶボタンはいらないのでは?」と気づいたため削除しました。 ユニコードの入力形式を指定できる仕様を依頼したのは自分ですけどね。

そんなこんなで細かい微修正(手作業)をし、比較的シンプルな表示に変更した結果をデプロイしました。

スタイルを削除+微修正結果

なぜ微修正を Claude に依頼しなかったのかというと、 微修正した結果のコードは Claude 上にあるため、毎回ダウンロード → ローカルで確認、という作業が必要であり、 この作業が非常に面倒なことに気がついたからです。

Claude チャット画面での修正結果 (ファイル)

2回目: Claude Codeでリファクタリング

コードの微修正をチャット機能に依頼するのは無理だと気がついたので、おとなしく課金しました。

$22.00/1 monthです。円安も相まって、高い買い物だなと思ってしまいます。

Unicode ページ、使っていて気がついたのが、以下でした。

  • \uXXXX、U+XXXX だけじゃなく、文字を直接入力して使いたい
  • 「使用例」が場所を異様にとっているし、表示がダサいのでなんとかしたい

ローカルにあるレポジトリ shihono-nextjs-test を参照させて、順番に対応しました。 (業務では使っているのですが)やはりコードを実際に参照したほうが圧倒的に作業しやすいです。

1個目の「文字を直接入力して使いたい」についてはほぼプロンプトだけで対応できました。 追加したコードの冗長性が気になったので、追加で Claude に修正させて完了。

2個目については「使用例」が button 要素なのが問題ということはわかったのですが、 CSSを調整しても margin が広すぎる問題が解消しなかったので、削除することにしました。 その代わりに textarea にデフォルト値を入れるよう指定。

だいぶシンプルになりました。

現状のページ

おわりに

コードを書く時、最低限のコードから始めて、機能を追加していくことが多いのですが、 Coding Agent の生成結果は完成形なので、 コードを書くときとは違う労力がかかる感じがします。

生成結果から不要な部品を消していく作業ですね。 自分は生成結果のコードを読み、対応方針を決め、Coding Agentに依頼、を何度か繰り返す感じです。

Coding Agent に勝手にブラッシュアップさせる方法でも大丈夫なのかもしれないですが、 最初の生成物が思ったのと全然違ったので、慎重になってしまいました。

自分が作りたいものが作れるよう、使いこなせるよう、引き続きやっていきます。

前回

eieito.hatenablog.com

# NLP2026読んだ・聴いた論文メモ

昨年 と同様、言語処理学会年次大会の論文についてまとめます。

予稿集ページを参考にしています。

(目次をつけ忘れていたので追記)

P1-3 LLM-jp FactCheck:学習コーパスに照らした真偽検証によるモデル応答の分析

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/P1-3.pdf

  • 学習コーパスから根拠となるテキストを検索・取得し、モデル応答の真偽判定をするシステム
    • モデル応答を言説に分割
    • 言説から根拠テキストを検索
    • 根拠テキストから各言説の真偽を判定
  • モデルが誤回答している場合でも、学習コーパス中に正解に関する記述が存在することがある
    • → モデルの誤回答は必ずしも誤情報の学習に起因しない

関連論文

B1-14 n-gramに基づく推論モデルの信頼度と較正特性の分析

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/B1-14.pdf

  • Chain-of-Thought (CoT) で不確実性表現があるのに出力が過信的になる問題
    • 「A か B か判断が難しい」「情報が不足している」
  • 推論部分の信頼度を目的変数として回帰分析
    • 実験した全てのモデルにおいて信頼度が高い時に相応した正解率が出ていない、常に過剰信頼
    • 信頼度は推論結果の正確さそのものよりも,推論過程がどのような言語表現であるかに強く影響される
  • 信頼度の算出方法
    • 生成させる ( think タグ部分を入力してスコアづけ)
    • 強制デコード 各選択肢に対する確率分布 P(x_i)
  • 信頼度に影響する言語的特徴
    • 推論中の検討や再思考を示す表現が信頼度を高める
      • option, option hmm let try,maybe,perhaps
    • 思考を整理する表現が信頼度を下げる
      • perhaps mistake wait let check, let check, subtract
  • (感想) 推論と出力がチグハグにならないための工夫の余地はあるのだろうか

C1-12 テレビ音声コーパスに対するテキスト補完と読み付与

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/C1-12.pdf

  • テレビ字幕の省略や表記揺れをWhisperを用いて補完する
    • 漢字かな混じりWhisper、音素/カタカナ出力にファインチューニングしたWhisper、字幕の3つをアライメントする

C1-23 Toward Factual Summarization through Consensus and Consistency

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/C1-23.pdf

Q2-5 BCCWJ2 構築に向けた漢字カタカナ文抽出ツールの開発

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/Q2-5.pdf

  • 古文的・漢文的表現で漢字とカタカナのみの文があり、形態素解析の精度に影響
    • e.g. 人倫ノ重キヲ思ヒ。
  • 漢字カタカナ文判定ツール→人の作業のサポート用のツールを開発

B3-10 大規模言語モデルの手順型応答を対象としたファクトチェックフレームワークの構築

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/B3-10.pdf

  • 手順を対象としたファクトチェックフレームワーク ProcedureFC を提案、評価するためのベンチマークを構築
  • 個々の行為、ステップとアドバイスや注意事項などの補足情報を検証

Q4-18 文埋め込みモデルの内部表現と不均衡最適輸送を用いた機械翻訳自動評価

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/Q4-18.pdf

  • 文埋め込みモデルの文脈埋め込みをトークンとし、参照文と生成文のトークンの輸送計画を求める
    • 不均衡最適輸送(UOT)に基づいた輸送計画
  • 輸送量の総和を真陽性(TP)として解釈し,トークン重みとの差分から偽陽性(FP)および偽陰性(FN)を定義
  • 不均衡最適輸送で参照文・対象文で対応関係がないトークンがある場合も対応する
  • (感想) 言語間でトークンは1対1関係ではないので、情報の輸送として捉えるのは直感的に正しいように感じた

B5-2 LLMエージェントにおける指示曖昧性の内部表現解析

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/B5-2.pdf

  • 「LLM 内部における指示曖昧性の処理メカニズムの解明」が目的
  • LLMの内部状態を Linear Probing で解析する
    • Instruction Tuning 済み LLM を用いて、隠れ状態ベクトルを入力とし、指示の明確性ラベルを予測する分類器を学習
  • モデル内部の曖昧性表現がテキスト出力に十分に反映されていない可能性が示唆された
    • LLM が内部で曖昧性を表現していても,「実行可能」な振る舞いを優先し、応答には顕在化/活用されない可能性
    • CoT(Chain-of-Thought)はタスク成功率に寄与するが、内部の曖昧性識別精度には寄与しない。エージェントの制御と曖昧性は区別して扱う必要性がある
  • 曖昧性判断、既存研究 The Curious Case of Hallucinatory (Un)answerability: Finding Truths in the Hidden States of Over-Confident Large Language Models (Slobodkin et al., EMNLP 2023)
  • (感想) 実社会での使用において、どこまで曖昧性を考慮すべきだろうか

B5-14 (A6) 言語モデルにおける既知性判断のメカニズム

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/B5-14.pdf

  • 知識の既知性: 入力された知識が自身が正確に予測できる知識か否か
    • 知識の (subject, relation, object) triple において (subject, relation) を入力とし object を予測できるとき既知とする
  • 予測の整合性と既知性判断の因果関係を検証
    • 既知性判断: Zero-shot プロンプトで subject, relation, object を入力し、 Yes/No の出力で判断
    • 入力整合性(傾向) : 内部的に想起した object と,実際に入力された object の整合性 relation の最終トークン位置の LM ヘッドにおける,実際に入力された object の対数確率を用いる
    • 入力整合性(因果): 隠れ状態において、内部的に想起した objectに介入し、既知性判断に与える影響を調査 介入によってモデルの既知性判断が反転した事例の割合を計算
  • 実験の結果: 内部的に想起した単語と入力された単語の情報との整合性から自身の想起可能な関係知識か否かを判断し、出力していることが示唆された
  • (感想) 学習データにある情報かどうかの検証とも比較してみてみたい

P8-18 文章執筆支援のための項省略の可否判断予測モデル

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/P8-18.pdf

  • 日本語では項はしばしば省略される
    • 項 = 述語に関連した主語や目的語を表す名詞句、下の *紅茶を*
    • 太郎は友人から紅茶をもらった。家に帰ってから家族と *紅茶を* 飲んだ。
  • 読み手に意図が伝わりやすい文章のためには、項を適切に挿入する必要がある
    • 適切な項省略の可否判断支援を見据えたモデルの構築を目指す
  • 項を表出するかどうか、項を表出する必要がある場合は「どの位置に何の格を表出すべきか」を予測するタスク
  • 項の表出必要度スコアはサプライザルを用いて定式化

P9-9 多観点検証に基づく要約における忠実性向上

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/P9-9.pdf

  • 複数の検証エージェントが異なる観点から要約を確認し,指摘に基づいて反復的に修正を行う多観点からの検証に基づく要約フレームワーク
  • 「事実整合性・数値/時間・固有表現・照応関係」に特化した検証エージェントを導入、指摘に基づいて反復的に修正する枠組を提案
  • 忠実性指標を改善

Q9-15 文法誤り訂正における編集ベクトルの最適輸送に基づく性能評価尺度

https://www.anlp.jp/proceedings/annual_meeting/2026/pdf_dir/Q9-15.pdf

  • 文法誤り訂正、参照あり評価の評価尺度
  • 編集ベクトル: 編集を適用する前後の文表現の差分
    • 文表現=エンコーダで文埋め込みを計算したベクトル
  • UOT (不均衡最適輸送) でシステム出力 (仮説) から人手の訂正結果 (参照) へ輸送することでアライメントをとる
  • より多くの輸送が行われるほど仮説と参照の編集が類似する、とみなす
  • 単純な正解・不正解の二値評価ではなく,部分点を適宜与えるような評価が可能
  • 輸送計画の可視化はスコアの解釈に有用

終わりに

なんだかんだ去年と同じく4月になってしまいました……。反省。

eieito.hatenablog.com

# Rust の candle で hugging face model を動かしたかった

Rust ができるようになりたくて勉強している。学んだことを記録しておく。

Learn Rust にある “the book” を進めている。

Rust 言語の特徴的な部分はわかってきたので、ちょっと実践的なコードを書いてみたくなった。

candle

https://github.com/huggingface/candle は Rust で ML モデルを動かせるフレームワークである。

huggingface にあるモデルも動かせる。 が、ドキュメント など読む限り safetensors 形式のモデルが推奨っぽい。

VarBuilder に .from_npz, .from_pth という関数が実装されてはいる。

(ちなみにドキュメントは現時点で 6.2 MNIST までしか公開されていない)

hf_hub

huggingface のモデルをダウンロードするには hf_hub を使う。

use hf_hub::api::sync::Api;
use std::path::PathBuf;

fn download_model ()  -> Result<(PathBuf, PathBuf, PathBuf)> {
    let api = Api::new().unwrap();
    let repo = api.model("{{MODEL_NAME}}".to_string());

    let config = repo.get("config.json")?;
    let weights = repo.get("model.safetensors")?;
    let tokenizer = repo.get("tokenizer.json")?;
    // println!("config {},\nweights {},\ntokenizer {}", config.display(), weights.display(), tokenizer.display());
    Ok((config, weights, tokenizer))
}

candle_transformer

transformer を扱うモジュールとして candle_transformers がある。

Python の transformers と同じように BERT, LLaMA などのモデルをサポートしている。 例えば BertModel だと hf_hub でダウンロードしたモデルを以下のように読み込むことができる。

Rust だと型が定義されているので type hint で何をやっているのかわかりやすい。

use candle_transformers::models::bert::{BertModel, Config, DTYPE};

fn load_model(
    config_path: PathBuf,
    weights_path: PathBuf,
    device: &Device,
) -> Result<BertModel> {
    let config: Config = serde_json::from_slice(&std::fs::read(config_path)?)?;

    let device = Device::Cpu;

    let vb = unsafe {
        candle_nn::VarBuilder::from_mmaped_safetensors(
            &[weights_path],
            DTYPE,
            &device,
        )?.pp("bert")
    };
    let model = BertModel::load(vb, &config)?;
    println!("load model");
    Ok(model)
}

注意点

試しに上記関数 load_model で bert-base-uncased を読み込もうとしたが、

Error: cannot find tensor embeddings.word_embeddings.weight

Error: cannot find tensor bert.embeddings.LayerNorm.weight

といったエラーが出て読み込めず断念……。

これは candle_transformers で想定している safetensors key と実際の key が異なるのが原因らしい。

(key の rename で読み込めそうだが、そこまで修正が必要なら BertModel を使う必要性はないのでは……という気持ちになった)

README やcandle-examples/examples に例として紹介されているモデルなら動くと思われる。

そういうわけで、candle_transformers は Python の transformer と完全に互換性があるわけではないことに注意が必要。 (pipeline とか、フォルダがあるだけで中身が空っぽだったいるする……)

Memo

月イチでブログを書こうと思っていたが、 ちょっと中途半端な状態なので、2月に調べたことのまとめとして公開してみる。

仕様を調べたり、Rust コードの生成には ChatGPT と Claude を使った。

このブログ記事自体は 真心込めた 手打ちでお送りしている。

最終チェック (校正) には Claude を使った。 モデル名の表記を正しく修正し、文体が混在している箇所については「である調」に統一をした。

# Spacy の Matcher クラスを日本語モデルで使う

Spacy の Matcher を使えば、正規表現ライクに token の検索が行える。

もちろん日本語モデルでも使える。 キーワードだけでなくフレーズの抽出にも便利なので使い方をまとめる。

動作確認は Google Colab で行った。

import spacy
from spacy.matcher import Matcher

# 日本語モデルを読み込む
nlp = spacy.load('ja_core_news_sm')

# モデルのバージョンを確認
print(f"ja_core_news_sm モデルのバージョン: {nlp.meta['version']}")
>> ja_core_news_sm モデルのバージョン: 3.8.0

動作確認に使った notebook は Gist ( https://colab.research.google.com/gist/shihono/7c2250676aaff45f3027c36cafe5d897/spacy_matcher_ja.ipynb ) にアップロードした。

なお、Matcher 以外に DependencyMatcher と PhraseMatcher があるが、この記事では扱わない。

基本的な Matcher の使い方

ドキュメントや各所に記載があるので詳細は割愛する。 Google Colabの Gemini で適当なプロンプトを投げても問題なく実装できたので (下記コード) 問題ないと思う。

Matcher クラスは初期化時に nlp.vocab (Vocab)が必要なことに注意。

また、パターンを追加時にパターンの名前が必要。 これは出力時に match_id として使っている。

# Matcherクラスを初期化する
matcher = Matcher(nlp.vocab)

# パターンを定義する
pattern1 = [{'ORTH': '東京'}, {'ORTH': 'タワー'}]
pattern2 = [{'ORTH': '人工'}, {'ORTH': '知能'}]
pattern3 = [{'POS': 'NOUN'}, {'POS': 'NOUN', 'OP': '?'}, {'ORTH': 'です'}]

# パターンをMatcherに追加する
matcher.add('TOKYO_TOWER', [pattern1])
matcher.add('AI', [pattern2])
matcher.add('NOUN_DESU', [pattern3])

text = "私は東京タワーに行きたいです。人工知能は素晴らしい技術です。これはペンです。"
doc = nlp(text)

print("マッチング結果:")
for match_id, start, end in matcher(doc):
    string_id = nlp.vocab.strings[match_id]  # マッチIDを文字列に変換
    span = doc[start:end]  # マッチしたスパンを取得
    print(f"  {string_id} ({match_id}): {span.text} (インデックス: {start}-{end})")

>>
マッチング結果:
  TOKYO_TOWER (13499316988715407544): 東京タワー (インデックス: 2-4)
  AI (5530044837203964789): 人工知能 (インデックス: 9-11)
  NOUN_DESU (5674413237057723623): 技術です (インデックス: 13-15)

以降のパターンは TEXT を使っているが上記コードの ORTH と同じ。 ドキュメント でも説明が全く同じなので。

Operator を使う

Operator で正規表現のように曖昧な表現を検索できる。

注意した方がいいのは、この曖昧検索は最長の一致部分ではなく、 すべての一致パターンを返す 点。

例えば、直喩パターン (まるで)?({NOUN})(の)?(よう)(だ|に|で)? を考える。

simile_pattern = [
    [
      {"TEXT": "まるで", "OP": "?"},
      {"POS": "NOUN", "OP": "+"},
      {"TEXT": "の", "OP": "?"},
      {"TEXT": "よう"},
      {"TEXT": {"IN": ["だ", "に", "で"]}, "OP": "?"}
    ]
]
simile_matcher = Matcher(nlp.vocab)
simile_matcher.add("SIMILE", simile_pattern)

"まるでライオンのようだ。" という例文においては ? の要素のありなしで4つの結果を返す。

// マッチした span と text, pos
まるでライオンのようだ。
    SIMILE: 'まるでライオンのよう' ['まるで,ADV', 'ライオン,NOUN', 'の,ADP', 'よう,NOUN']
    SIMILE: 'まるでライオンのようだ' ['まるで,ADV', 'ライオン,NOUN', 'の,ADP', 'よう,NOUN', 'だ,AUX']
    SIMILE: 'ライオンのよう' ['ライオン,NOUN', 'の,ADP', 'よう,NOUN']
    SIMILE: 'ライオンのようだ' ['ライオン,NOUN', 'の,ADP', 'よう,NOUN', 'だ,AUX']

ユニークに絞り込みたい場合、spacy の関数 util.filter_spans を使うとよさそう。 matcher の結果を span に変換する必要はあるが。

from spacy.util import filter_spans

# match 結果を最長一致でユニークにする
doc = nlp("まるでライオンのようだ。")
spans = [doc[start:end] for _, start, end in simile_matcher(doc)]
unique_spans = filter_spans(spans)

for span in unique_spans:
    print(span.text)
# まるでライオンのようだ

Attribute を使う

token の要素でマッチするので、 IS_XXX や LIKE_XXX といったフラグだけでなく、 形態素解析 (Sudachi) の出力で抽出することができる。

形態素解析結果について、品詞は tag, 読み・活用型・活用形 は morph に格納されている。

tag は 名詞-固有名詞-地名-一般 のように - 区切りになっていて、 morph は Reading=XXX のように key value が = で区切られる。

pos だと Universal dependency によるおおまかな分類になってしまうし、 形態素解析の品詞とposが一致しない時があるので1、そういう場合は tag を活用したい。

[
    [{"TAG": {"IN": ["名詞-固有名詞-地名-一般", "名詞-固有名詞-地名-国"]}}]
]

# 「新宿駅から西武新宿駅まで。東京都新宿区。」の出力
#   TAG: '新宿' ['新宿,名詞-固有名詞-地名-一般,Reading=シンジュク']
#  TAG: '新宿' ['新宿,名詞-固有名詞-地名-一般,Reading=シンジュク']
#  TAG: '東京' ['東京,名詞-固有名詞-地名-一般,Reading=トウキョウ']
#  TAG: '新宿' ['新宿,名詞-固有名詞-地名-一般,Reading=シンジュク']

morph は複数の要素が含まれている。 読みの場合は Reading=XXX とすればいい。

活用形・活用型は Inflection=活用型;活用形 の形式なので、同時に指定するときはいいが、 活用形だけ指定したいときは REGEX を使って曖昧検索をする。 (場合によっては品詞の絞り込みも必要)

[
    [{"MORPH": {"REGEX": "Reading=シ.+"}}],
    [{"MORPH": "Reading=トウキョウ"}]
]

# 「新宿駅から西武新宿駅まで。東京都新宿区。」の出力
# MORPH: '新宿' ['新宿,名詞-固有名詞-地名-一般,Reading=シンジュク']
# MORPH: '東京' ['東京,名詞-固有名詞-地名-一般,Reading=トウキョウ']
# MORPH: '新宿' ['新宿,名詞-固有名詞-地名-一般,Reading=シンジュク']

# 「相手を叱った。」の出力
# MORPH: '叱っ' ['叱っ,動詞-一般,Inflection=五段-ラ行;連用形-促音便|Reading=シカッ']

morph については下記でもまとめている。

eieito.hatenablog.com

参考


  1. spaCy の /spacy/lang/ja directory に Sudachi の品詞から pos への変換辞書がある↩

# 詳しくない言語の発音をローマ字表記にする + epitranの紹介

「日本語(というか漢字)は表意文字なので読めなくても意味はわかる。表音文字は意味はわからなくても読める」 という話がある。 前者の主張はわかるが、正直なところラテン文字以外は発音を推定することは難しい(私の場合)。

そういうわけで、色々な言語をローマ字に変換する仕組みを考える。

言語ごと直接変換するのはコストが高いため、まずは文字を 国際音声記号(IPA) に変換した上でローマ字に変換する。

国際音声記号 (IPA) に変換

国際音声記号(IPA) に変換するのには epitran を使う。 多言語対応のライブラリは Python だとこれ一択の模様。

研究成果として公開されたもののようだが (https://aclanthology.org/L18-1429/ ) 、今もメンテナンスされている。ありがたい。

言語のサポート状況は README に記載されている。 使いたい言語 (Code) を指定して Epitran クラスで宣言する。

import epitran

epi = epitran.Epitran("code")

日本語を発音記号に

日本語対応もしているので試しに実行する。

日本語は Code が複数ある。 ひらがな (jpn-Hira)、カタカナ (jpn-Kana) に関してはそれぞれの文字種のみ変換する。

>>> epi = epitran.Epitran("jpn-Hira")
>>> epi.transliterate("とうきょうと、トウキョウ、東京")
'toːkʲoːto、トウキョウ、東京'

>>> epi = epitran.Epitran("jpn-Kana")
>>> epi.transliterate("とうきょうと、トウキョウ、東京")
'とうきょうと、toːkʲoː、東京'
>>> epi = epitran.Epitran("jpn-Jpan")

漢字を含む jpn-Jpan に関しては open-dict-data の ja.txt を辞書データとして使っている。

ひらがな・カタカナ部分について微妙に出力が変わる。 また、辞書ベースの仕組みのため変換できない可能性がある。

>>> epi = epitran.Epitran("jpn-Jpan")
>>> epi.transliterate("とうきょうと、トウキョウ、東京")
'toɯきょɯto、toɯkiョɯ、toɯkjoɯ'

>>> epi.transliterate("私は夢洲に行った")
'ɰᵝataihajɯmeɕɯɯnigjoɯっta'

>>> epi.transliterate("大規模言語モデル、つまりLLMのことだ")
'daikibogeɴkjomodeɾɯ、tsɯmaりLLMnokotoda'

ロシア語をローマ字っぽくする

ここから本題。ギリギリ読めないキリル文字で実験する。

ロシアの地名を Wikipedia ページ Список городов России с населением более 100 тысяч человек (人口10万人を超えるロシアの都市の一覧) のテーブルから取得。

日本語表記を正解データとして扱えるよう、 langlinks で対応する日本語ページも取得する。 日本語がない地名は落として、 156個 のデータを取得した。

// ロシア語地名と日本語
[
    {
        'target': 'Москва',
        'ja': 'モスクワ'
    },
    {
        'target': 'Санкт-Петербург',
        'ja': 'サンクトペテルブルク'
    },
    {
        'target': 'Новосибирск',
        'ja': 'ノヴォシビルスク'
    },
    {
        'target': 'Екатеринбург',
        'ja': 'エカテリンブルク'
    },
]

MediaWiki API にリクエストし、 その結果を wikitextparser で色々操作しただけなので実装の詳細は割愛。

発音記号をローマ字に変換

epitran の変換結果をローマ字に変換する。

国際音声記号の文字一覧 を参考にルールベースで変換する。

変換を単純化するために母音と子音以外は変換の対象から除外する実装とした。

ipa_to_roman の実装は gist にアップロードした。

gist.github.com

検証

日本語カタカナもローマ字に変換した上でコサイン類似度を算出する。

カタカナからローマ字の変換は jaconv、 コサイン類似度は textdistance を使う。

def katakana2roman(text):
    """カタカナをローマ字に変換"""
    text = jaconv.kata2hira(text)
    # ゔ を v に
    text = text.replace("ゔぁ", "va").replace("ゔぃ", "vi").replace("ゔぅ", "vu")
    text = text.replace("ゔぇ", "ve").replace("ゔぉ", "vo").replace("ゔ", "v")
    # 長音・記号を空白に
    return jaconv.kana2alphabet(text).replace("ー", " ").replace("・", " ")

epi_ru = epitran.Epitran("rus-Cyrl")

sim_result = []

for d in data["data"]:
    # カッコははぶく
    ru_text = d["target"].split(" (")[0]
    ja_text = d["ja"].split(" (")[0]
    ru_ipa = epi_ru.transliterate(ru_text)
    # ja_ipa = epi_ja.transliterate(ja_text)
    ja_roman = katakana2roman(ja_text)
    ru_roman = ipa_to_roman(ru_ipa)
    sim = textdistance.cosine(ru_roman, ja_roman)
    sim_result.append([ru_text, ja_text, ru_roman, ja_roman, sim])

結果は以下のようになった。 ru_roman がロシア語のローマ字表記、 ja_roman が日本語のローマ字表記。

ru ja ru_roman ja_roman similarity
0 Москва モスクワ moskva mosukuwa 0.721688
1 Санкт-Петербург サンクトペテルブルク sankt-petervurɡ sankutopeteruburuku 0.710819
2 Новосибирск ノヴォシビルスク novosivirsk novoshibirusuku 0.778499
3 Екатеринбург エカテリンブルク yekaterinvurɡ ekaterinburuku 0.741249
4 Казань カザン kazan kazan 1

類似度 (similarity) の平均は 0.767622 でそこまで低くない印象。

# similarity (pd.describe)
count    156.000000
mean       0.767622
std        0.112924
min        0.462910
25%        0.683370
50%        0.771517
75%        0.843744
max        1.000000

実例

類似度の高い上位10個

ru ja ru_roman ja_roman similarity
8 Уфа ウファ ufa ufa 1
38 Пенза ペンザ penza penza 1
32 Кемерово ケメロヴォ kemerovo kemerovo 1
4 Казань カザン kazan kazan 1
51 Иваново イヴァノヴォ ivanovo ivanovo 1
137 Раменское ラメンスコエ ramenskoe ramensukoe 0.948683
150 Камышин カムイシン kamishin kamuishin 0.942809
125 Коломна コロムナ koromna koromuna 0.935414
115 Салават サラヴァト saravat saravato 0.935414
13 Воронеж ヴォロネジ voronej voroneji 0.935414

6文字ぐらいの単語でも類似度が高く表記できている。

類似度の低い上位10個

ru ja ru_roman ja_roman similarity
76 Тамбов タンボフ tamvov tanbofu 0.46291
99 Бийск ビイスク viysk biisuku 0.507093
113 Керчь ケルチ kerty keruchi 0.507093
86 Братск ブラーツク vratxk bura tsuku 0.516398
133 Рубцовск ルプツォフスク ruvtxovsk ruputsuofusuku 0.534522
126 Кызыл クズル kizir kuzuru 0.547723
140 Черкесск チェルケスク tyerkessk chierukesuku 0.57735
85 Великий Новгород ノヴゴロド verikiy novɡorod novgorodo 0.583333
66 Владикавказ ウラジカフカス vradikavkaz urajikafukasu 0.585369
144 Артём アルチョーム artom arucho mu 0.596285

日本語ではバ行表記 (b) 、原語だと v 表記の場合は類似度が低くなってしまう。 他は母音の不一致が多い。

Кызыл の変換結果 kizir と クズル は母音が全く違うので詳しく調べてみる。

ロシア語での発音は kɨzɨl で母音 ɨ は 非円唇中舌狭母音。 日本語では表記できない発音らしい。

このあたりは日本語の限界を感じる。 音で聞くと「クィズィル」みたいに聞こえた。

参考

eieito.hatenablog.com